大模型行业正在出现一条斩杀线。
不是开源模型每一项都超过闭源模型,而是它们开始在足够多的真实任务里越过“够用线”。
一旦模型够用,价格就会变成问题。
一旦价格变成问题,闭源模型就不能再只卖“更强”。它必须证明自己贵得有道理。
这就是 Kimi K3 和 DeepSeek V4 Flash 放在一起时,真正有意思的地方。
Kimi K3 负责把开源模型的能力上限顶到第一梯队。DeepSeek V4 Flash 负责把 Agent(智能体,能连续执行多步任务的 AI)调用成本压到足够低,尤其是编程场景。一个打能力,一个打价格。
合在一起,它们不是简单地宣布“闭源模型没用了”,而是开始问闭源模型一句很难回答的话:
你贵这么多,到底贵在哪里?
一、过去的问题是:开源能不能追上
过去一段时间,开源模型一直在回答一个问题:
我能不能追上闭源模型?
这个问题的隐含前提是,闭源模型默认更强,开源模型负责追赶。用户付费给闭源模型,买的是更高的能力上限、更稳定的体验、更少的折腾。
只要能力差距足够明显,价格就不是最核心的问题。
你不会拿便宜的替代品去处理高风险任务。写关键代码、长上下文分析、多轮工具调用、重要决策辅助,这些场景里,用户愿意为确定性付费。
但现在问题开始变了。
Kimi K3 整体表现仍落后于最强闭源模型——官方自己也承认这一点。但它已经是一个 2.8 万亿参数、百万级上下文的开源大模型,面向长程代码编写、知识工作和推理,性能进入前沿水平。
这个定位很关键。
它不是说开源已经全面赢了,而是说比较方式变了。Kimi K3 的意义不在于某一项榜单分数,而在于:开源模型第一次在很多人关心的任务上,接近了“可以认真比较”的位置。
过去是“闭源能做,开源不能做”。现在越来越多任务变成“闭源做得更好,但开源也能做,而且便宜很多”。
商业压力往往不是从第一名开始的,而是从“够用的第二选择”开始的。
二、这就是斩杀线
如果说 Kimi K3 更多是在能力维度把开源模型抬进第一梯队,那 DeepSeek V4 Flash 更像是在成本维度把门槛压下来。
在一份长期私有测评榜单中,DeepSeek V4 Flash 0731 的推理分数没有排到最前面,但它的测试成本非常刺眼:同一张表里,GPT-5.5 测试成本是百元级,Kimi K3 也是百元级,DeepSeek V4 Flash 0731 只有个位数。
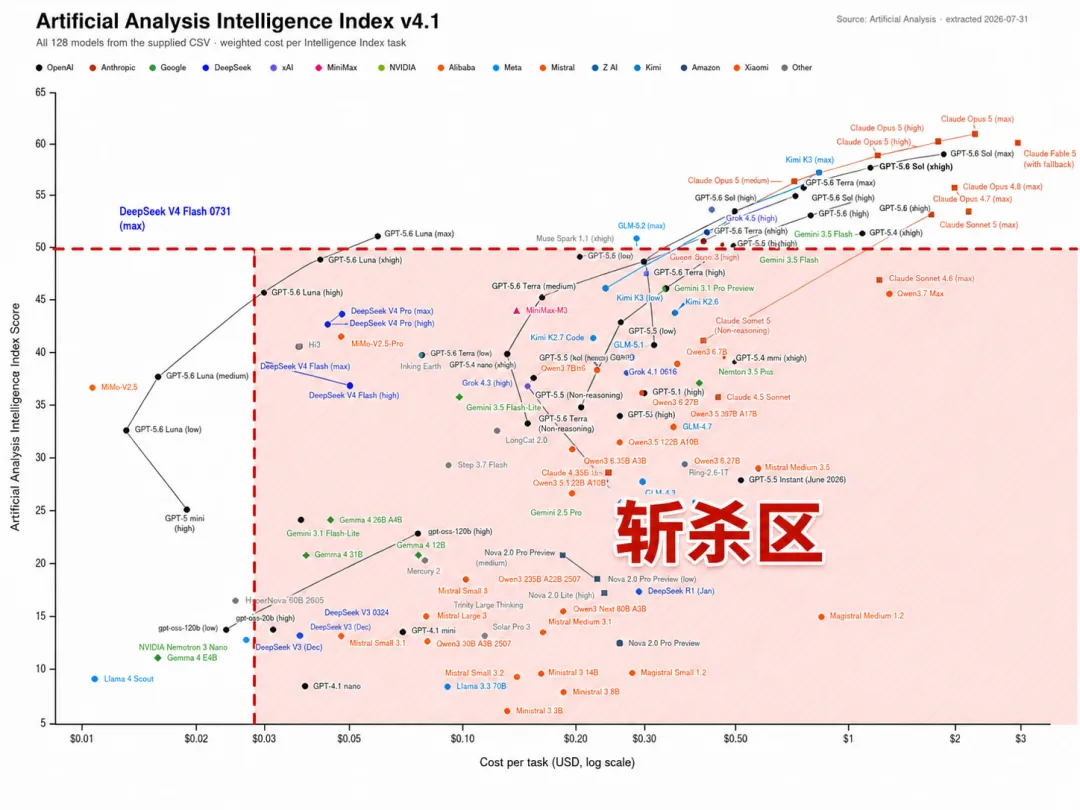
当模型进入 Agent 任务后,成本不再是附带指标,而是能力的一部分。
因为 Agent 和聊天不一样。
聊天是一次回答,Agent 是连续行动。它会读文件、跑命令、调用工具、看结果、再决定下一步。一旦任务链路变长,token 消耗、工具调用、失败重试和上下文续接都会放大成本。
在这个场景里,一个模型便宜一点,不只是账单好看。
它意味着你敢不敢让它多试几轮,敢不敢让它跑夜间任务,敢不敢把它放进日常开发工作流里。
更重要的是,这不是只停留在一张榜单里。
OpenRouter 的公开数据显示,DeepSeek V4 发布后,其 token 份额从年初的约 9% 翻倍到 6 月初的近 20%——而 token 份额增长远超其支出份额增长,因为太便宜了,同样的钱能消耗更多 token。TechNode 报道也证实,V4 Flash 在 7 月最后一周处理了 7.22 万亿 token。
性价比已经在驱动真实采用,而不是只驱动围观。
DeepSeek 这次更新的重点也正在这里。
DeepSeek 官方更新日志写明,V4-Flash 0731 强化了 Agent 能力,在多个主流编程 Agent 基准测试中刷新成绩,并针对 Codex 做了原生适配。DeepSeek 甚至提供了一键配置方案,让开发者可以在几分钟内把 Codex 的模型提供商从 OpenAI 切换到 DeepSeek,迁移成本几乎为零。
这说明它不是只在聊天框里便宜,而是在试图接入开发者真实工作流。
不过,便宜不等于永久便宜。
DeepSeek 官方价格页已经提示:未来会整体提高 API 服务价格,而且预计涨幅显著,具体价格方案以后续官方通知为准。
这条提示很重要。它不是把这篇文章的判断推翻了,反而把问题说得更清楚:DeepSeek 的低价不是一个永恒承诺,而是一次价格锚点重置。
它先让开发者看到,Agent 任务原来可以用更低成本跑起来;随后即便涨价,用户心里的参照系也已经变了。闭源模型不能再只用“我更强”解释溢价,开源和低价模型也不能只用“我更便宜”维持吸引力。即便未来涨价,讨价还价的主动权也已经转移——接下来真正要比较的是:每一档价格背后,到底买到了什么确定性、工具适配、上下文管理和稳定体验。
开源模型真正打闭源模型的地方,可能不是“我在榜单上高你 0.5 分”,而是:
我让你原来舍不得跑的任务,变成可以认真算账。
所谓“斩杀线”,不是谁排第一。
它是一个商业阈值:
当更开放、价格可比的选择在大多数日常任务里够用且可信,闭源的高溢价就会被迫重新解释。
这条线一旦出现,用户心里的问题会发生变化。
过去用户问:
哪个模型最强?
现在用户会先问:
这个任务真的需要最强吗?
这是两个完全不同的问题。
第一个问题有利于闭源模型。因为只要第一名足够耀眼,用户就会默认往第一名靠。
第二个问题有利于开源模型。因为大多数真实任务并不总是需要第一名。它们需要的是稳定通过、价格可控、能接工具、能批量跑、能被自己掌控。
所以 DeepSeek 预告涨价之后,这条线也没有消失。
因为斩杀线从来不是“永远两块钱”。它真正改变的是比较方式:用户开始把能力、价格、开放性和工作流绑定在一起算总账。
一旦用户开始按任务分层,闭源模型就会失去一部分默认流量。
最强模型仍然会留在最高风险、最高价值、最高不确定性的场景里。 但大量中低风险任务会被拆出去,如资料整理、代码初稿、测试生成、批量改写、数据清洗、日常 Agent 流程。
这些任务过去可能都被闭源订阅包住。
现在,它们开始有了替代路线。
三、过去卖模型能力,现在卖留下来的理由
所以你会看到另一个变化:闭源平台开始重新经营默认选择权。
OpenAI 一边把 GPT Luna 放进免费入口,一边下调 Luna / Terra 的价格,并把这种成本变化反映到 Codex 和 ChatGPT Work 的用量计量里;Anthropic 也在 Fable 5 短暂暂停后恢复访问。
更强能力被放进更低门槛的入口,订阅权益的边界正在反复调整。
这些现象不必强行归因于某一家竞争对手。
更稳的判断是:当开源模型越过够用线,闭源平台不能只卖“模型更强”,它还要卖“为什么你应该继续留在这里”。
第一,Agent 时代的用户不是一天问几十次,而是让模型连续跑任务。限制太紧,重度用户会被迫寻找替代品。
第二,一旦用户把 Kimi、DeepSeek、Qwen、本地推理服务、开源 Agent 框架接起来,迁移成本就会反过来变高。闭源厂商最怕的不是用户今天省了一点钱,而是用户明天养成了不用它的工作流。
第三,价格战已经从 API 进入产品体验层。闭源模型不能只说自己更强,还要让用户感到“我留在这里更省心”:更多额度、更少打断、更稳定的任务状态、更好的上下文管理、更少莫名其妙的风控误伤。
过去闭源卖的是模型能力。
现在,它开始卖留下来的理由。
四、闭源还剩什么
闭源模型当然还有价值。
但从现在开始,它的价值必须被证明,而不能被默认。
闭源模型真正有价值的地方,可能会从“单点模型分数”退到更靠后的几层:
- 稳定性:关键任务能不能少掉链子;
- 体验:多端、上下文、文件、项目、记忆和工具链能不能顺;
- 生态:IDE、办公软件、企业系统、插件市场能不能接好;
- 信任:数据边界、合规、审计、赔付和责任归属能不能说清楚;
- 品牌:用户在高风险场景里愿不愿意把结果交给它。
这些东西都很值钱。
但它们不是“默认值钱”。
开源模型把闭源模型从神坛上拉回了交易桌。你可以贵,但你要说明贵在哪里。你可以闭源,但你要给我省掉足够多的麻烦。你可以限制使用,但你不能把重度用户逼去重建一套自己的工作流。
这就是开源模型现在最锋利的地方。
它不是一定要在每个 benchmark 上拿第一。
它只要在足够多任务上过线,就会改变定价权。
结尾
开源模型不再只是追赶者。
它开始变成闭源模型商业化的压力测试。
Kimi K3 问的是:开源模型的上限到底能到哪里?
DeepSeek V4 Flash 问的是:如果 Agent 任务可以用更低成本跑起来,闭源订阅还凭什么维持原来的溢价?
最终被改变的,不只是模型排行榜。
而是用户第一次有底气问:
如果 80 分的能力已经足够完成任务,90 分的能力凭什么维持原来的溢价?
现在,轮到闭源模型报价了。