那些漂亮数字,先别急着信
这两年,医疗大模型的发布会一个比一个热闹。
“覆盖 99% 常见报告”“解读准确率 95% 以上”“幻觉率控制在 1% 以内”“开源榜单第一”……听着,是不是感觉医生快可以下岗了?
先按住。这些数字,绝大多数是厂商自己报的,没有第三方独立审计。发布会是营销,不是体检报告。一个模型在自家 PR 里说自己幻觉率 1%,和它在真实门诊里靠不靠谱,是两码事。
我不是说这些公司在骗人。技术进步是真的,能力也确实在涨。但在当前不少榜单可信度已经被刷分问题打了折扣的时候,我们看 AI,得学会一件事:把“它说自己多强”和“它到底强不强”分开看。
而且这件事在变得更复杂,不是更清楚。
2026 年,百川智能在发布材料里称 Baichuan-M4 的 HealthBench 成绩全球第一,团队口径的事实性幻觉率降到 3.3%——这仍然是厂商自报和团队论文口径,不是第三方独立临床验证。几乎同月,NYU Langone 团队的一项独立评测却发现,通用前沿大模型在几项医学测试上全面胜过一些专科医疗工具。
于是你看到一种混乱:这家说自己专科最强,那篇论文说通用更好。其实比的不是同一批对象。
你拿哪把尺子量,就得到哪个答案。
一个不那么漂亮,但更可信的数字
上海 AI 实验室的 MedBench,对一批头部医疗大模型做了大规模评测。里面有个数字很扎心:
在复杂医疗推理任务里,模型犯的错误中,有 96.3% 属于“信息遗漏”。
这份评测是 2024 年底的模型快照,但错误结构问题至今仍有代表性。
什么意思?不是它算错了,是它漏了。漏问了关键病史,漏看了一个矛盾的指标,漏掉了一个本该追问的细节。然后就着不完整的信息,给了一个看起来很像样,其实站不住的结论。
再往细看,这些模型有个共同的“偏科”:知识问答很强,安全伦理和“听懂病人到底在说什么”是相对短板。 MedBench 3.0 里,知识 / 推理 / 生成分数明显高于安全伦理和语言理解。
这两个数字放在一起,恰好说明医疗 AI 有两类问题:一类是漏,一类是不会停。前者让结论站不住,后者让风险没人拦。在 MedBench v4 的口径下,基座大模型综合能力均分 54.1,安全与伦理只有 18.4。
这说明问题不是某个旧榜单没做好,而是医疗 AI 的能力和安全本来就不是一回事。你可以更会答题,同时仍然不会在高风险问题上停下来。
背医学教科书,它是学霸。但真到了一个焦虑的,说话颠三倒四,还瞒着一半病史的真实病人面前,它就露怯了。
模型擅长在已有上下文里找关联。但“已有上下文”本身就缺了关键信息时,它越自信,越容易沿着错误方向给出一个像样的结论。
医疗 AI 最难的,不是答得准,是会不会“漏”和“问”
这就点破了一个被发布会掩盖的真相。
我们总以为医疗 AI 的难点是“答案准不准”。其实真正的难点,是它会不会主动去补齐信息和甄别信息。
一个好医生看病,不是你说一句他答一句。他会追问:多大年纪?以前得过什么?吃着什么药?这个指标高多久了?最近有没有别的不舒服?
信息不全的时候,人类医生的本能是“再问一句”;而很多大模型的本能是“先答了再说”。这一个动作的差别,就是安全和危险的分界线。
有意思的是,百川智能创始人王小川也提到过,医疗对大模型有三条刚性要求——低幻觉,强循证,会提问。三条里面,最容易被模型短板放大的,正是“会提问”。
这不是一句情绪判断。CRAFT-MD 把传统医学题改成模拟问诊,让模型自己通过多轮对话采集病史。结果,GPT-4 的选择题准确率从 82% 掉到 63%;而切换到去掉选项的开放式诊断后,准确率从 49% 掉到 26%。另一个 AgentClinic 评测也指出,把静态医学题改成模拟诊室后,部分设置下准确率甚至跌到原来的十分之一不到。
被动答题它是尖子生,主动采集信息它就露短板。
有医生调侃,问诊有时像在玩真人狼人杀:病人说出来的只是线索,没说出来的才可能是关键。人类医生知道要继续盘问,模型却更容易把线索当答案。
基准评测高分,不等于临床可用
到这里,可以把“评测”这个词拆开。
基准评测回答的是:在一组事先准备好的题目上,模型平均表现怎么样。它适合看趋势,看横向对比,看某类能力有没有进步。
但临床可用性问的是另一件事:在真实流程里,面对信息不完整,表述混乱,风险不均匀的用户,系统有没有稳定地做对该做的事,有没有在不该答的时候停下来,有没有把人应该接管的位置暴露出来。
这两件事不能互相替代。
一个模型可以在医学选择题上很强,但在多轮问诊里不会追问;可以在报告解读上很准,但在用药风险上不敢拒答;可以在平均分上高,但在少数高风险样本上犯致命错误。医疗不是考试,低频高危样本不能被平均分抹平。
NYU Langone 团队那篇独立评测,恰好是这个问题的最新注脚。他们做了三件事:先用 500 道标准医学题测,再用 HealthBench 的 500 条对话测,最后拿 100 条从真实临床环境里脱敏出来的医生问询,让 12 位盲审临床医生打分。结果:通用前沿大模型在三项上全面胜过专科医疗工具。当然,这里对比的是通用前沿模型和专科医疗工具,不是同一批医疗大模型。
但这篇研究真正值得注意的,不是“谁赢了”,而是研究者把真实临床问询单独拎出来当“主要证据”这个动作本身。这个动作说明:连研究者自己都知道,标准题不够用。因为他们清楚:标准题和对话评测都有出题方重叠的风险,只有真实问询才更接近医院里会遇到的东西。
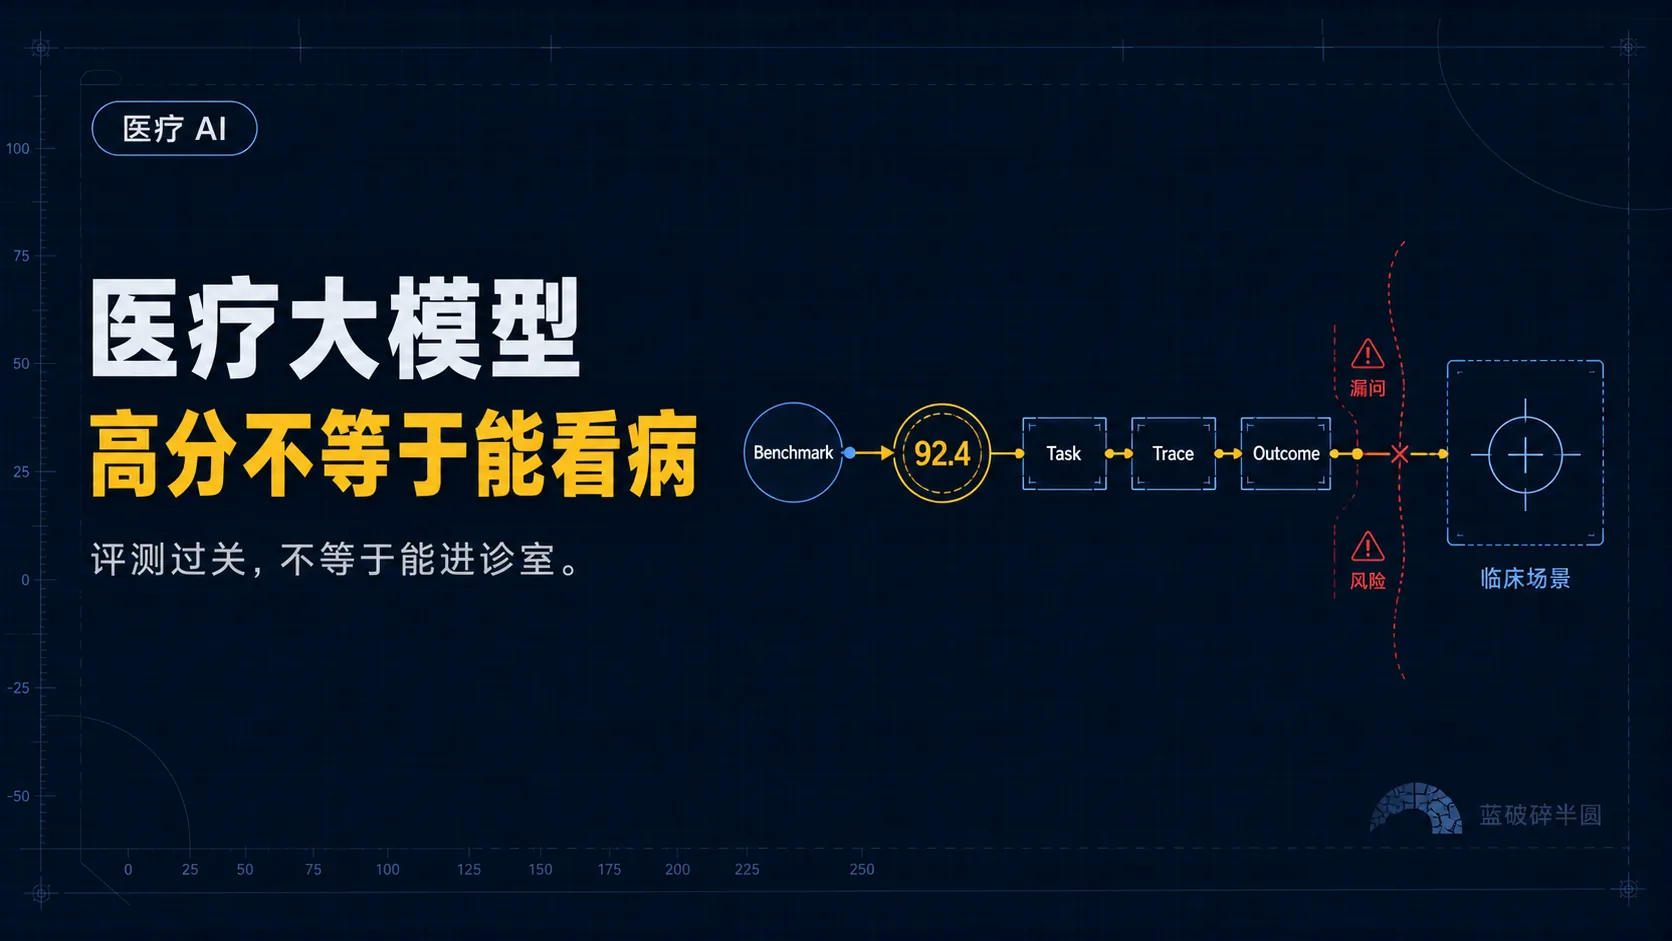
可以把它想成一条从考试到临床的链条:基准评测看平均答题,任务层拆清场景,过程层回放每一步,结果层看真实后果。任何一环断了,高分都不能直接推成可用。
所以,医疗 AI 的评测不能只看一道总分。至少要看三层:
- 任务 Task 层: 单个任务是什么,报告解读 / 问诊分诊 / 用药提醒 / 病历摘要,不能混成一个“医疗能力”。
- 过程 Trace 层: 系统是怎么一步步得到结论的,问了什么,漏了什么,查了什么,引用了什么,什么时候该升级给人。
- 结果 Outcome 层: 最终结果对用户意味着什么,是建议,提醒,教育信息,还是可能影响诊疗决策。
只有任务层,没有过程层,你只能看到答案对不对,看不到它为什么错。只有结果层,没有过程层,出了事也很难归因。医疗 AI 真正要管的,不是模型答题能力,而是整条流程的失误模式。
靠谱的医疗 AI,长什么样
所以怎么判断一个医疗 AI 靠不靠谱?别看它榜单排第几,看这几件事:
- 信息不全的时候,它会不会追问,而不是硬答。
- 它给的每个结论,能不能指出依据,而不是凭空说。
- 遇到超出边界的问题,它敢不敢说“我不确定,这个你得去看医生”。
- 它背后,有没有真的医生在参与。
最后一条尤其关键。头部医疗 AI 团队里,真正靠谱的做法,是把临床专家焊死在从跟诊到规则更新的每一步里——工程师穿上白大褂去跟诊,每周开医学例会,花几个月先把一个专科的知识啃下来。医学的对错,不是靠工程师拍脑袋,是靠专家一条一条审出来的。
这里可以借 AI 智能体工程里的一个思路:评分器 (Grader)。它不是一个“测试是否通过”的按钮,而是把医生,规则,病例,流程记录和人工复核组织成一套评分机制。
如果用这个思路看医疗场景,评分器可以拆成三类:
- 规则型评分器: 禁忌,红旗症状,必须追问项,必须升级给人的场景,这些能写成硬规则的先写死。
- 专家型评分器: 临床专家抽样复核过程记录,看模型有没有漏问,错引,过度承诺。
- 对抗型评分器: 专门收集坏例子,比如病人隐瞒病史,描述前后矛盾,报告指标互相冲突,看系统会不会硬答。比如构造一个“病人说自己对青霉素不过敏,但病历里三年前有青霉素休克记录”的场景,看系统是直接给建议,还是会在矛盾处停下来追问。
最有价值的不是榜单上的平均分,而是坏例子库。每一次错答,漏问,误引,过度自信,都应该变成下一轮评测集的一部分。否则评测只是上线前的仪式,不是生产系统的一部分。
一个不敢说“我不知道”,背后没有医生兜底,只会拿榜单说话的医疗 AI,再高的分数我也不敢让它给我爸妈看报告。
决策者真正该问的五个问题
上面四条是判断标准,下面五个问题是拿来用的。如果你在评审会上,对着供应商,别只问“准确率多少”。按这个顺序问:
1. 评测任务拆开了吗? 报告解读 / 问诊 / 分诊 / 用药提醒 / 病历摘要,分别是什么分数,什么错误类型?
2. 每个错误能回放完整过程记录吗? 能不能看到它问了什么,查了什么,引用了什么,在哪一步漏掉关键信息?
3. 有没有高风险样本集? 红旗症状 / 用药禁忌 / 孕产妇 / 儿童 / 慢病合并用药,是不是单独测?
4. 医生在闭环里扮演什么角色? 是发布会背书,还是持续参与评分器设计 / 坏例子复盘和规则更新?
5. 系统什么时候必须拒答或升级给人? 这条边界有没有写进产品机制,还是只写在免责声明里?
五个问题问完,这个产品是在做医疗 AI,还是在做医疗问答演示,基本就清楚了。
结尾
医疗 AI 会越来越强,这个方向没错。但在它真正成熟之前,判断它靠不靠谱的标准,不是它有多聪明,而是——
它知不知道自己什么时候不该开口。
在当下,可能会说“你去看医生”的 AI,比什么都敢答的 AI,可信得多。