大家好,我是 NLP(自然语言处理)练习时长三年半的算法工程师,喜欢用 Python 来对万物进行 Embeddings[1] 和 Tokenization[2]。
在我以为离开了卷到头的 CV 后,可以沿着 NLP 技能树一步一步向上攀登的时候。ChatGPT 横空出世,对互联网上第一批使用它的人说道:「大人,时代变了。」
NLP 不存在了?
恐慌,失业,失眠
在 ChatGPT 发布后一周,虽然圈子里吹了一星期,我并不以为意,毕竟 GPT3,T5 这种大模型都是用过的,只是比 Siri、某猫精灵、某爱同学好一点,但也只是好一点,虽然到处屠榜,但在使用上依然是「人工智障」。
终于一条回复引起了我的注意。
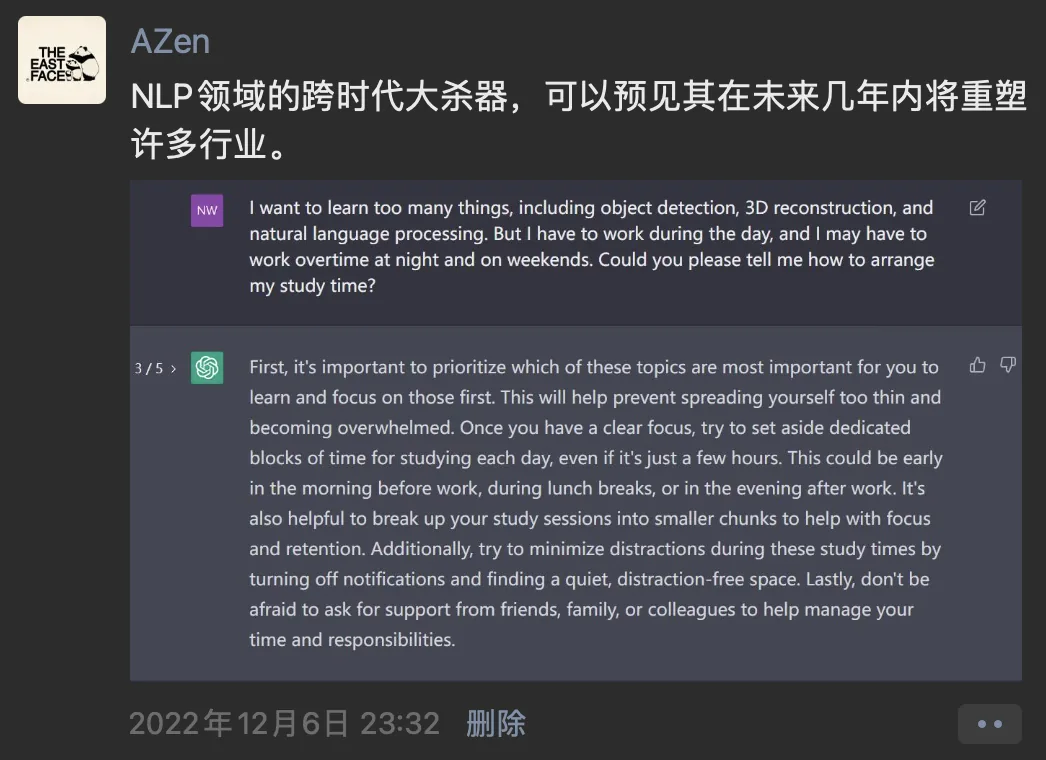
虽然这条回复是 ChatGPT 在为人做心理辅导,但看完后我的心理状况却没有得到宽慰,短短一段话里可以发现 ChatGPT 完成了阅读理解,情感分析并做出了非常得体的回复。
这时候作为一个 NLP 领域的算法工程师,我已经慌了,如果这段回复不是数据集内原来已经有的答案的话,那么 ChatGPT 就只能是发明了什么外星黑科技。未来任何跟文字(广义上可以用键盘打出来的东西)打交道的工作,都会受到波及。
随着与 ChatGPT 多次的对话后,我有点慌了。NLP 不存在了,NLP 算法工程师也不存在了,或者说很多传统 NLP 的任务已经不存在了。不再需要单纯的算法专家去设计单个的 NLP 能力。我距离失业也仅仅是时间的问题了。
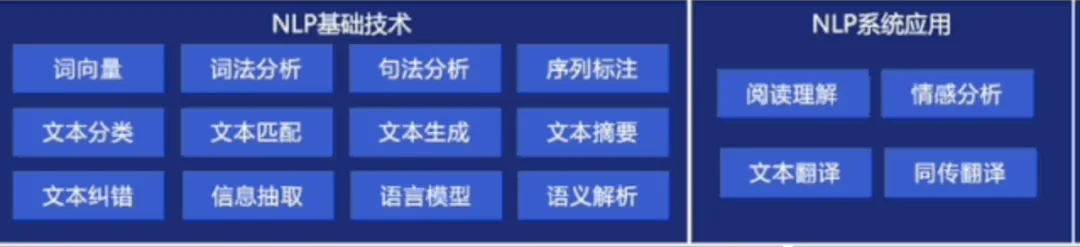
传统 NLP 技术及研究内容(已经不重要了,后面可能没人再研究了)
随后的 2 个月里,一遍遍询问 ChatGPT 它的原理,也一遍遍重读《Attention is all you need》(Transformer),《Improving Language Understanding by Generative Pre-Training》(GPT1),《Language Models are Unsupervised Multitask Learners》(GPT2),《Language Models are Few-Shot Learners》(GPT3)等与其相关的论文。但读得越多就越不理解。
只是 Transformer 结构的线性叠加,除了模型越来越大外,什么无监督、多任务、少样本这些论文里写烂的东西。
尤其任务类型还是生成式,做出来能做什么,大型的「狗屁不通文章生成器」?
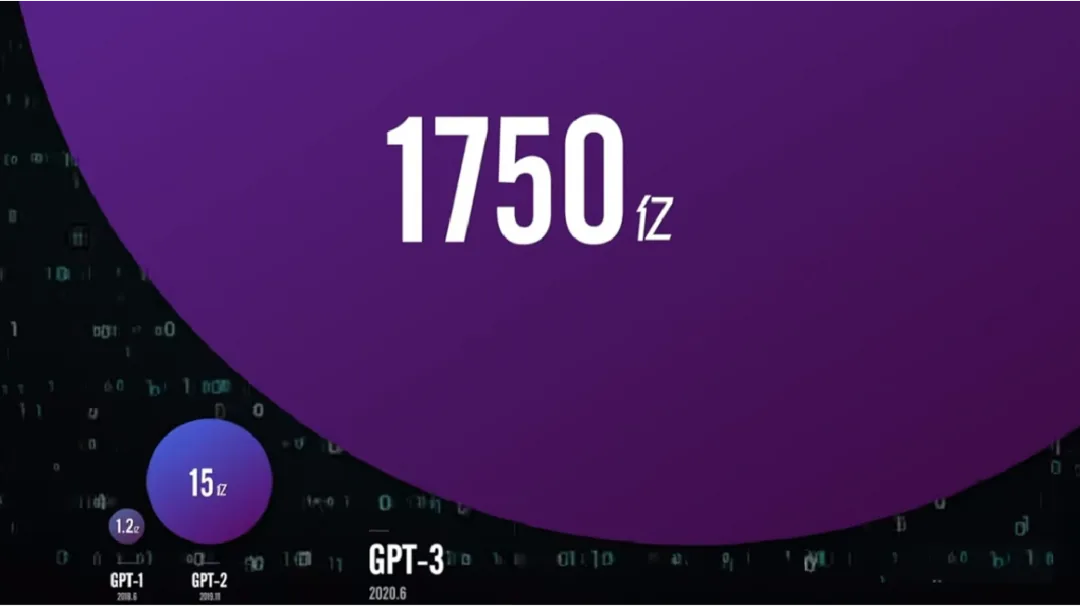
GPT 家族参数量级(基于公开论文)
NLP 不存在了。
太棒了,我逐渐理解这一切了。
三个月,我得了新冠,阳了,躺平,除了放空什么事也做不了的时候,心态却开始逐渐平复。
再读《Training language models to follow instructions with human feedback》(InstructGPT),大模型 LLM 的《Emergent Abilities of Large Language Models》(涌现),《Chain-of-Thought Prompting Elicits Reasoning in Large Language Models》(思考链条 COT)(ps:这两篇很好读,一个公式都没有)之类描述大模型为什么效果好的文章后。
在深度学习领域里,大部分结果都是效果好,但无法解释为什么效果好的这个「传统常规」路径,我也只能开始接受大力出奇迹这个结果。
我能怎么办呢,在深度学习上,效果就是一切,「机械飞升」也是人类未来进化的方向之一。与其欺骗自己,自怨自艾外,还有一条人机协同进化的新路线。
除了关心 ChatGPT 后的技术及原理外,开始花时间如何去使用 ChatGPT。
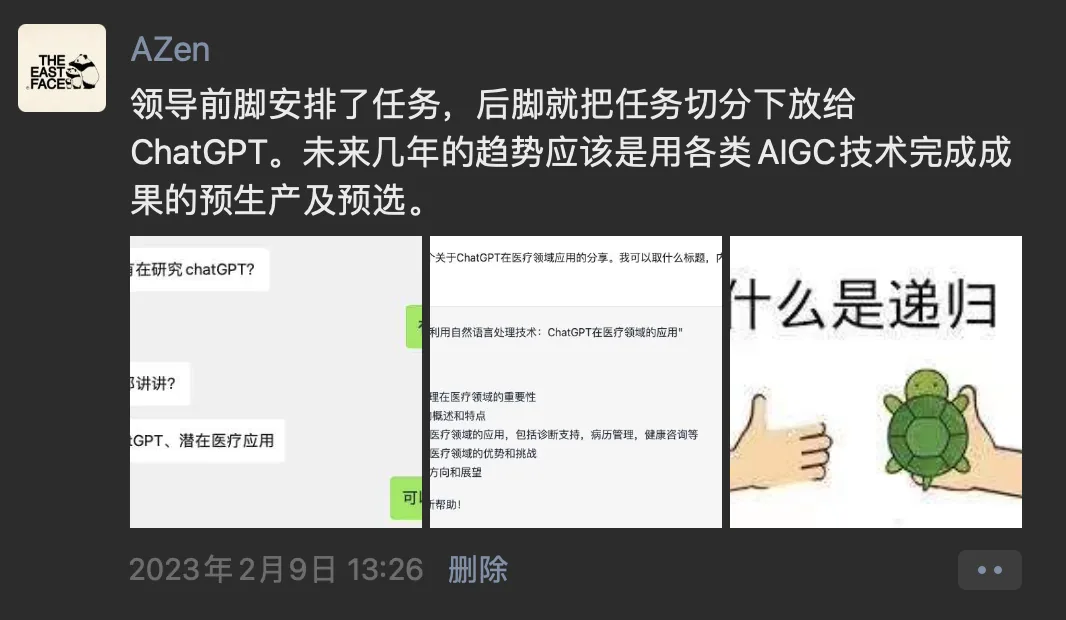
并同时开始试用及使用各类 AIGC 类的产品,grammarly、DeepL、Midjourney、Jasper、Stable Diffusion、Copilot。但在完成度上都没有达到 ChatGPT 的水平。
同时,可以发现所有跟文字(广义上一切可以用键盘敲出来的内容)工作相关的 AIGC 工具,在通过 Prompt 进行领域调优后,在保留一个 ChatGPT 的情况下,其他的都可以删了。
虽然在 ChatGPT 出现后,再讨论 AI 什么时候可以通过图灵测试已经是毫无意义的事情。
或者说,「传统的」图灵测试已毫无意义,你是否能区分对面是不是机器,并不能作为对方是否有真正的意识的证明。
ChatGPT 或者说 GPT3.5 的发布,让我觉得已经又到了一个新瓶颈,后续很长一段时间都只维持在这个水平的时候。
GPT-4 发布了。
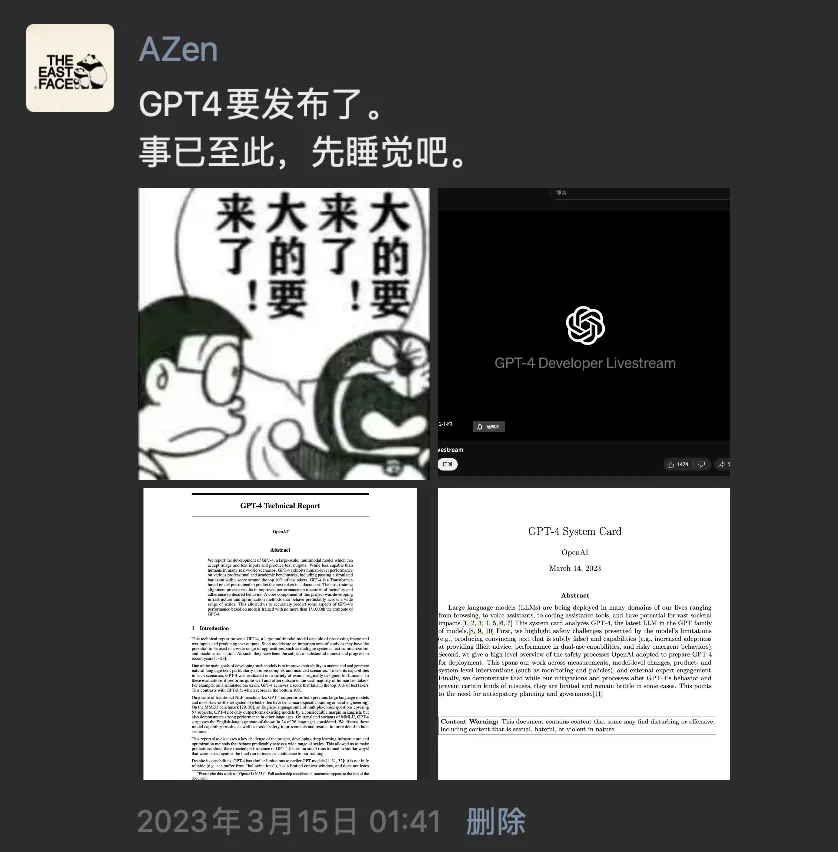
后续的情节就像《三体》小说里描述的「技术爆炸」一样,时间以周为单位,一个个重磅更新发布了。
Notion AI,midjonery V5,GPT-4 office,Copilot-X,GPT Plugin。
每一个都是可以颠覆行业的重磅产品。
到了这个时候,事件开始出圈,失眠的人群扩大了。
在 MIT MOOC 上 Python 及机器学习的「校友群」内,产品、UED、VR 开发、后端、前端、运维都有点坐不住了。于是群主顺势组织了线下聚会。
总的来说,人多力量大,逐帧拆解了近期的几场发布会。部署并测试了 OpenAI 的 Whisper 模型,Meta 的 LLaMA 模型,清华的 chatglm 模型。
在大模型这个体量下,哪怕有带有 GPU 的服务器,我们也还是体会到了被美国芯片封锁的「卡脖子」痛苦。
经过一天友好地「树新风」(Tree New Bee),并在讨论了后续的技术及个人发展方向后。
大家的结论收敛在了一起,谨慎乐观。
NLP 不存在了!
AGI,一切都才刚开始
新技术,尤其是革命性新技术的产生,会淘汰许多旧有工作及岗位,但同时也将以同样的速度创造新工作。
只是原来设想先从体力劳动者的工作开始替代的 AI,采用了迂回的道路,先袭击了 AI 从业者,随后开始偷袭脑力劳动者。
尤其在阅读完微软发布的这篇 154 页的《Sparks of Artificial General Intelligence: Early experiments with GPT-4》论文后。论文主要是对 GPT4 的各项指标如何做定量分析所做的实验,并提出 GPT4 可能是通用人工智能 AGI 的起点。
但我主要想分享的是 10.3 这一小节。
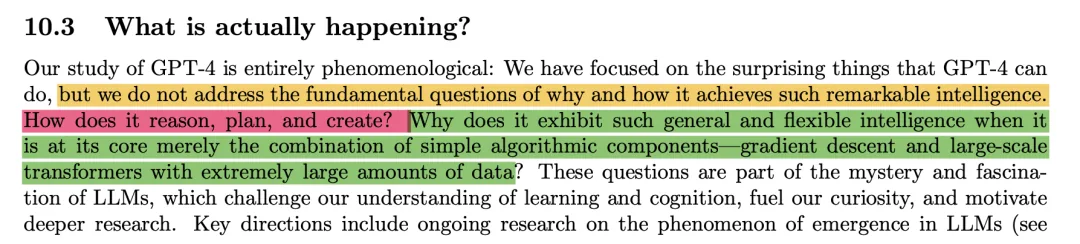
《Sparks of Artificial General Intelligence: Early experiments with GPT-4》
大致的意思是:
- 我们造出了 GPT4,但我们无法解释 GPT4 为什么如此智能。
- GPT4 已经拥有了人类意识的雏形。
行吧,原来微软你个浓眉大眼的家伙也不知道原理。
22 年 8 月研发出来的 GPT4,已经研究了大半年,还没找到 GPT 的抓手,这样怎么赋能其他产品,还怎么击穿用户心智?
但从结果上来看,如果将 AGI 比作蒸汽机,将再带来一次工业革命。那么目前的 GPT4 可以比作珍妮纺纱机。能操控机器的人,生产效率将成倍提升。
AI 会不会替代人,因为人类是不会被某项技术所淘汰,而是被掌握更高技术的人踢出局。不要和车去比速度。要学会开车,学会去驾驭。
因此最后,对于 NLP 工程师,NLP 并没有不存在,反而出现了许多新的研究方向。
GPT 的开源实现、数据安全、降低消耗、减少幻觉 hallucination[3]、效果评估等都是后续的新研究方向。
同时在基于 GPT 下现有的 NLP 产品的研发新范式下。大部分 NLP 模型都需要重新研发一遍,以上都是 NLP 工程师后续可能的职业发展方向。
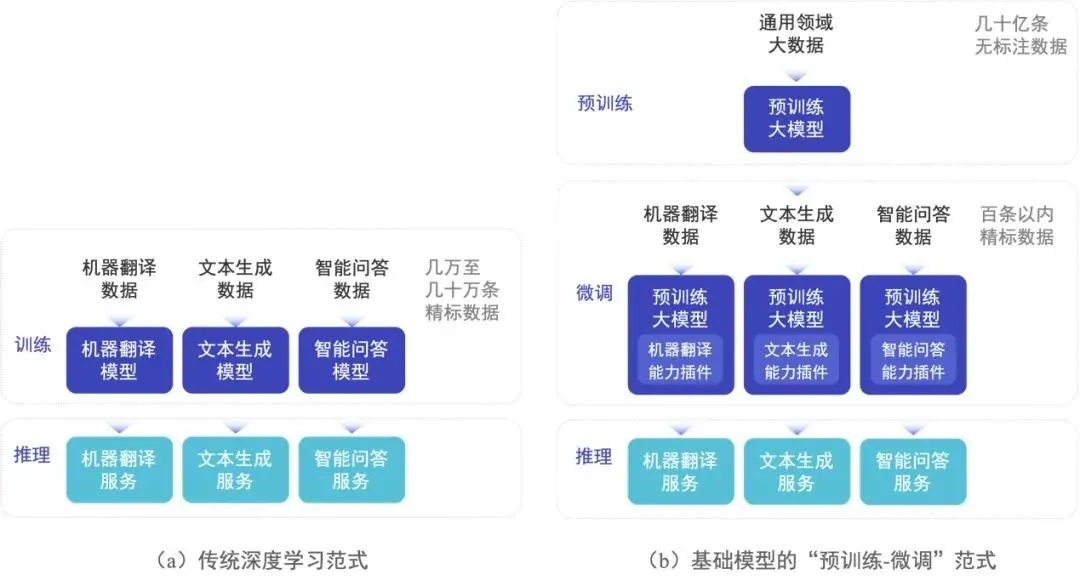
NLP 模型新范式
AGI is coming
我们可以做什么
而对于普通人而言,由于目前的「四重封锁」(境外访问、境外手机号、境外信用卡、境外 IP 封锁),对于 GPT 的使用,可以遭到中美一套「组合拳」,从认知到使用形成了全面的屏障。
但这不是我们不去学习掌握这些 AGI 模型的理由。在我看来,如何更快更好地驾驭 GPT 是当前最需要做的。
最后,截止本文章发布的日子,Meta 发布了 Segment Anything 大模型,Midjourney V5 发布了反向生成提示词(prompts)的功能,结合 GPT4 在发布会视频里展现的图片问答功能。可以合理推断大模型在 CV(计算机视觉)领域的 zero-shot 技术也基本上成熟。所以很快传统 CV 也要被革命了,很快也会喊出「CV 不存在了」。
三年半前还在想,从 CV 转 NLP 不知道是不是会是个错误的决定。
但现在各类大模型告诉我:「没关系的,都一样」。
在革自己命这条路上,程序员跟算法工程师做得比谁都彻底。
没关系的,都一样。—— 章北海
后续这个博客将继续分享各类基于大模型的好工具及如何使用 Prompt 更好地使用 GPT 等各类 AGI 模型,需要的同学请继续关注。
Reference
[1] Embeddings: Embedding(词嵌入)是自然语言处理和深度学习领域中的一个重要概念。它是将词语、短语或者其他文本信息转换成固定长度、数值型的向量(vector)表示的一种技术。
[2] Tokenization: Tokenization(标识化)将文本拆分成有意义的更小的语言单位,通常是单词、词汇或符号,便于计算机进行进一步的分析和处理。
[3] hallucination: 一本正经的胡说八道